Strukturierte Daten, JSON-LD und llms.txt im Vergleich – wann was für KI-Sichtbarkeit in ChatGPT, Perplexity und Google AI Overviews zählt
Seit llms.txt im Herbst 2024 aufgetaucht ist, werden beide Konzepte in Blogartikeln regelmäßig gegeneinander gestellt, als würden sie dasselbe Problem lösen. Das tun sie nicht.
Schema.org gibt es seit 2011 und ist ein ausgewachsener Web-Standard. Dagegen ist llms.txt ein Markdown-Vorschlag von September 2024, der noch kein formaler Standard ist. Trotzdem begegnen wir in der Praxis immer wieder Websites, die weder das eine richtig implementiert haben noch verstehen, warum das andere gerade so viel Aufmerksamkeit bekommt.
Dieser Artikel erklärt, was beide Konzepte wirklich leisten, welche Bots was verwenden, wo der Unterschied zwischen „Standard“ und „Community-Convention“ liegt – und was du für deine Website konkret priorisieren solltest.
Was schema.org ist – und was es nicht ist
Schema.org wurde 2011 gemeinsam von Google, Bing, Yahoo und Yandex gegründet. Das Ziel: ein gemeinsames Vokabular für strukturierte Daten, das Maschinen eindeutig sagen kann, was der Inhalt einer Webseite bedeutet. Nicht was dort steht – das können Crawler selbst lesen – sondern was es bedeutet.
Ein einfaches Beispiel: Auf einer Seite steht „Dr. Müller“. Ohne Schema-Markup muss eine Maschine interpretieren, ob das eine Person, ein Firmenname, ein Titel oder ein Filmcharakter ist. Mit Person-Schema plus sameAs-Verweis auf ein LinkedIn-Profil oder eine Wikipedia-Seite gibt es keine Interpretation mehr. Die Identität ist eindeutig.
Genau darin liegt der eigentliche Wert von Schema.org: Es reduziert Ambiguität – nicht nur für klassische Suchmaschinen, sondern auch für KI-Systeme, die heute immer häufiger entscheiden, welche Quellen als vertrauenswürdig gelten.
Wichtig zu verstehen: Schema.org ist kein Ranking-Signal. Google hat das mehrfach klargestellt. Korrektes Markup führt nicht automatisch zu besseren Positionen. Es sorgt aber dafür, dass KI-Systeme die richtigen Fakten aus einer Seite extrahieren können – ohne raten zu müssen.
Welche Schema-Typen 2026 wirklich relevant sind
Nicht jedes Markup hat denselben Stellenwert. In der täglichen Arbeit mit unseren Kunden zeigen sich immer wieder dieselben Lücken:
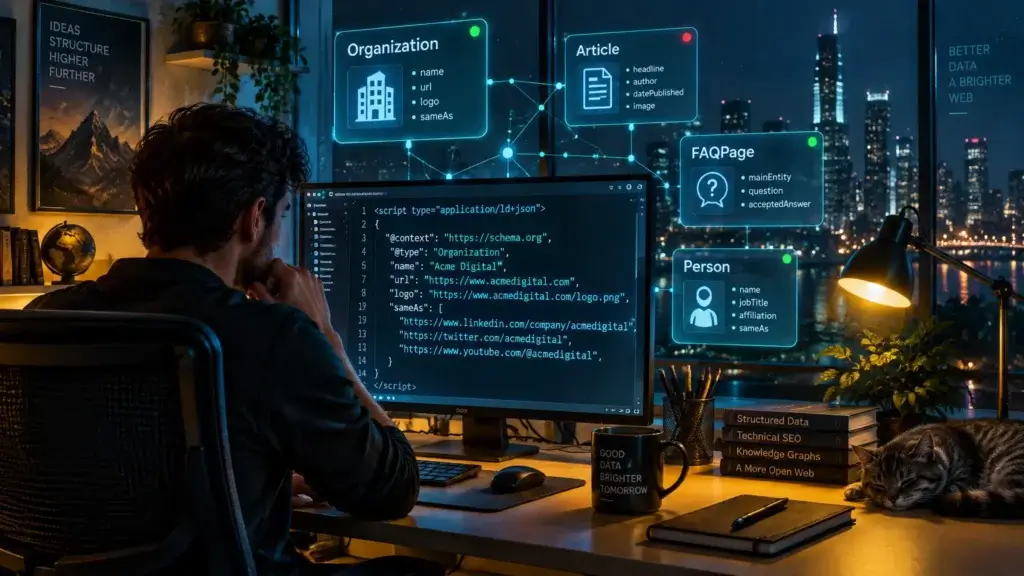
Organization-Schema auf der Startseite und der Über-uns-Seite ist Pflicht. Es ankert die Markenidentität und verbindet die Website über sameAs mit sozialen Profilen, Einträgen in Branchenverzeichnissen und Knowledge-Graph-Daten. KI-Systeme nutzen genau diese Verknüpfung, um eine Marke eindeutig zuzuordnen und nicht mit einem gleichnamigen Unternehmen zu verwechseln.
Article-Schema auf Blogartikeln und redaktionellen Inhalten mit korrektem Datum und Autorenangabe ist entscheidend für die Aktualitätsbewertung. Sprachmodelle priorisieren aktuelle, klar zugeordnete Inhalte. Wer kein Datum im Markup hat, riskiert, als veraltet eingestuft zu werden – auch wenn der Artikel erst letzte Woche erschienen ist.
FAQPage-Schema hat seinen visuellen Auftritt in den Suchergebnissen verloren. Google hat die FAQ-Rich-Results im Mai 2026 abgeschafft. Das Markup selbst ist aber weiterhin valide und wird von KI-Crawlern weiter genutzt. Der Grund: Frage-Antwort-Paare in maschinenlesbarem Format lassen sich von Sprachmodellen besonders einfach als zitierfähige Antwortblöcke extrahieren. Wer FAQ-Markup hat, erleichtert KI-Systemen die Arbeit enorm.
HowTo-Schema für Anleitungen funktioniert nach demselben Prinzip. Eine Schritt-für-Schritt-Anleitung, die bereits als strukturierte Sequenz vorliegt, wird von einem Sprachmodell zuverlässiger extrahiert als Fließtext, der zufällig eine Anleitung enthält.
Product- und Service-Schema für E-Commerce und B2B-Dienstleister ist unverzichtbar, sobald KI-Agenten konkrete Entscheidungen treffen oder Produkte vergleichen. Preis, Verfügbarkeit, Bewertungen und Servicebeschreibungen als strukturierte Daten ermöglichen es einem KI-System, präzise Empfehlungen zu geben.
Der kritische Hinweis dabei: Das Markup muss exakt das widerspiegeln, was auf der Seite sichtbar steht. Ein Preis im Schema, der nicht mit dem Seitenpreis übereinstimmt, wird von Suchmaschinen und zunehmend auch von KI-Systemen als Qualitätsproblem gewertet. Veraltetes Markup ist in vielen Fällen schlechter als gar keins.
Was llms.txt ist – und für wen es wirklich gemacht wurde
llms.txt wurde im September 2024 von Jeremy Howard, dem Mitgründer von Answer.AI, vorgeschlagen. Die Idee: eine einfache Markdown-Datei, die an der Root einer Domain liegt (/llms.txt) und eine kuratierte Liste der wichtigsten Seiten einer Website enthält – für KI-Agenten, die nicht die ganze Domain crawlen wollen.
Das klingt erst einmal nach einem sinnvollen Ergänzungsformat zu robots.txt und sitemap.xml. Der entscheidende Unterschied: robots.txt steuert den Zugang, sitemap.xml listet alle URLs vollständig auf, und llms.txt gibt eine kuratorische Prioritätsliste für KI-Agenten. Drei verschiedene Fragen, drei verschiedene Dateien.
Was llms.txt aber nicht ist:
Es ist kein offizieller Standard. Kein RFC-Prozess, kein IETF, keine Abstimmung mit Google, OpenAI oder Anthropic. Es ist eine Community-Convention, die auf llmstxt.org gepflegt wird. Das bedeutet nicht, dass es nutzlos ist – aber es bedeutet, dass man sich nicht darauf verlassen kann, dass irgendein System es verpflichtend auswertet.
Und genau das passiert auch nicht. Google hat öffentlich erklärt, llms.txt weder zu verwenden noch dies zu planen. OpenAI und Anthropic haben sich nicht offiziell dazu verpflichtet. Log-Analysen zeigen zwar, dass Search-Bots die Datei gelegentlich abrufen – ein Abruf ist aber kein Beweis für eine Verwendung als Ranking- oder Selektionssignal.
Wo llms.txt tatsächlich Wirkung entfaltet
Die belegte Nutzung von llms.txt findet an einem ganz anderen Ort statt: im Agentic Web. Coding-Assistenten wie Cursor, Claude Code und GitHub Copilot fetchen llms.txt, wenn ein Entwickler ihnen sagt, sie sollen sich mit einem bestimmten Produkt oder einer API beschäftigen. Statt die gesamte Dokumentationsseite inklusive Navigation, Footer und Cookie-Banner zu verarbeiten, liest der Agent die llms.txt und bekommt sofort eine kuratierte Liste der relevanten Seiten. Das spart Token, liefert schnellere Ergebnisse und reduziert Fehler.
Für wen llms.txt heute sinnvoll ist:
- SaaS-Unternehmen mit umfangreicher technischer Dokumentation
- API-Anbieter, deren Zielgruppe aktiv Coding-Assistenten einsetzt
- Developer-Plattformen, die in KI-gestützte Entwicklungsworkflows integriert werden wollen
Für wen der Mehrwert heute faktisch minimal ist:
- Klassische Business-Blogs ohne technische Zielgruppe
- Lokale Unternehmen und Dienstleister
- E-Commerce-Shops, deren Kunden keine Coding-Assistenten für den Einkauf nutzen
Die Implementierung selbst ist mit einem modernen SEO-Plugin wie Yoast oder Rank Math in unter einer Stunde erledigt. Der Aufwand ist gering, das Risiko ist null. Wer die Datei trotzdem anlegt, verliert nichts – sollte sie aber nicht als strategische SEO-Maßnahme betrachten.
Das Vier-Schichten-Modell: Wie Maschinen eine Website wirklich lesen
Um zu verstehen, wo beide Konzepte einzuordnen sind, hilft ein einfaches Modell, das wir intern verwenden:
Schicht 1 – Zugang: robots.txt und die Firewall-Konfiguration entscheiden, ob ein Bot überhaupt auf die Website kommt. Keine Optimierung der anderen Schichten hilft, wenn hier etwas blockiert wird.
Schicht 2 – Vollständigkeit: sitemap.xml zeigt dem Crawler, welche URLs existieren. Ohne eine aktuelle Sitemap werden neuere Seiten langsamer und unvollständiger indexiert.
Schicht 3 – Bedeutung: Schema.org gibt dem maschinellen Leser Kontext darüber, was der Inhalt einer einzelnen Seite bedeutet, wer dahintersteckt und welche Fakten vertrauenswürdig sind.
Schicht 4 – Kuratiertheit: llms.txt gibt einem KI-Agenten eine Prioritätsliste, wenn er die gesamte Domain navigieren soll.
Die Konsequenz aus diesem Modell ist eindeutig: Wer bei Schicht 1 oder 2 noch Lücken hat, sollte sich nicht mit Schicht 4 beschäftigen. Eine gepflegte llms.txt nützt nichts, wenn Search-Bots durch eine Cloudflare-Regel geblockt werden, bevor sie überhaupt zum robots.txt gelangen.
Die Crawler-Frage, die kaum jemand richtig beantwortet
Hier liegt der vielleicht wichtigste Punkt, den die meisten Artikel zum Thema auslassen.
KI-Anbieter wie OpenAI, Anthropic und Perplexity setzen 2026 unterschiedliche Bots für unterschiedliche Zwecke ein. Diese Unterscheidung ist entscheidend – und wird in der Praxis regelmäßig ignoriert.
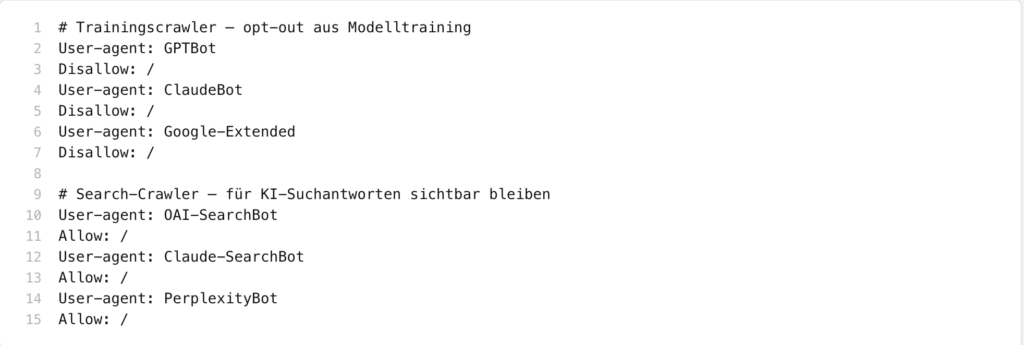
Trainingscrawler sammeln Inhalte, um Sprachmodelle zu trainieren. Dazu gehören GPTBot (OpenAI), ClaudeBot (Anthropic) und CCBot (Common Crawl). Diese Bots haben keinen direkten Einfluss darauf, ob eine Website in KI-generierten Suchantworten zitiert wird. Wer diese Bots blockiert, schützt seine Inhalte vor der Verwendung als Trainingsdaten – hat aber keinen Nachteil bei der Sichtbarkeit in KI-Antworten.
Search- und Retrieval-Crawler indexieren Inhalte für KI-generierte Suchantworten. Dazu gehören OAI-SearchBot (OpenAI), Claude-SearchBot (Anthropic) und PerplexityBot. Wer diese Bots blockiert – oft ohne es zu wissen, durch generische Firewall-Regeln – verschwindet aus KI-Suchantworten. Komplett. Kein Schema-Markup und keine llms.txt ändern das.
Das häufigste Problem in der Praxis: Unternehmen haben eine zu aggressive WAF-Regel auf CDN-Ebene, die alle unbekannten User-Agents blockiert. Der Search-Crawler kommt nicht mal zum robots.txt. Die Website ist in KI-Antworten unsichtbar – und niemand hat es bemerkt, weil es im Analytics-Report nicht auftaucht.
So prüfst du, ob deine Search-Crawler durchkommen
Der einzige verlässliche Weg ist die Server-Log-Analyse. Filter deine Logs auf die User-Agents der Search-Crawler und prüfe:
- Kommen 403- oder 429-Fehler zurück? Dann blockiert deine Firewall die Bots.
- Rufen die Bots nur die Startseite ab? Dann kommt die Website-Architektur dem tieferen Crawling in die Quere.
- Siehst du gar keine Einträge dieser Bots? Dann werden sie möglicherweise auf CDN-Ebene abgefangen, bevor sie deinen Server erreichen.
Eine minimale, praxistaugliche robots.txt-Konfiguration für 2026 unterscheidet klar zwischen Trainingsbots (blockiert) und Search-Bots (erlaubt):
Wichtig: JavaScript-basierte Inhalte werden von den meisten KI-Crawlern nicht gerendert. Inhalte, die ausschließlich über JavaScript geladen werden, sind für diese Bots unsichtbar – unabhängig davon, wie gut das Schema-Markup ist.
Was du wirklich haben solltest
Schema.org: Pflicht, keine Option
Schema.org ist für jede ernsthafte Website im Jahr 2026 nicht verhandelbar. Nicht weil irgendjemand es vorschreibt, sondern weil die Wahrscheinlichkeit, als verlässliche Quelle in KI-Antworten zu erscheinen, direkt davon abhängt, wie klar eine Website ihre Entitäten und Inhaltstypen definiert.
Die Mindestanforderung:
- Organization-Schema auf Startseite und Über-uns-Seiten
- Article-Schema mit Autor und Datum auf redaktionellen Inhalten
- FAQPage-Schema auf Seiten mit Frage-Antwort-Struktur
- Product- oder Service-Schema auf den entsprechenden Angebotsseiten
Dabei gilt: Weniger, aber korrekt ist immer besser als viel, aber widersprüchlich.
llms.txt: Sinnvoll für die richtige Zielgruppe
Für alle, deren Zielgruppe aktiv Coding-Assistenten oder KI-Agenten einsetzt, ist llms.txt eine niedrigschwellige, risikofreie Ergänzung. Die Implementierung dauert mit modernen Plugins weniger als eine Stunde.
Für alle anderen gilt: Die Datei schadet nicht. Sie bringt heute aber auch kaum messbaren Nutzen. Wer Zeit hat, kann sie anlegen – sie sollte aber nicht Teil einer strategischen SEO-Prioritätenliste sein, solange Schichten 1 bis 3 noch nicht abgedeckt sind.
Die eigentliche strategische Frage für 2026
Weder schema.org noch llms.txt sind die dringlichste Frage für die meisten Websites. Die eigentliche Frage lautet: Sind die richtigen KI-Search-Bots überhaupt in der Lage, die Website zu crawlen?
Wer das prüft, sein Schema-Markup korrekt und vollständig hält und Inhalte so strukturiert, dass ein Sprachmodell innerhalb weniger Sätze nach einer Überschrift eine verwertbare Antwort findet, wird mit oder ohne llms.txt wesentlich besser aufgestellt sein als jemand, der vier Stunden in eine llms.txt investiert hat, dessen OAI-SearchBot aber von Cloudflare geblockt wird.
Unterschiedliche Werkzeuge für unterschiedliche Fragen
Schema.org und llms.txt lösen keine konkurrierenden, sondern grundlegend verschiedene Probleme. Schema.org ist ausgereifte Infrastruktur, die seit 2011 standardisiert ist und von allen relevanten Suchmaschinen und KI-Systemen ausgewertet wird. Es arbeitet auf Seitenebene und schafft maschinelle Klarheit über Entitäten, Fakten und Inhaltstypen. Kein ernstzunehmender Webauftritt sollte darauf verzichten.
llms.txt ist ein cleverer Vorschlag mit echter Nischenanwendung im Developer-Ökosystem. Kein Standard, kein nachgewiesenes Ranking-Signal, aber eine sinnvolle Ergänzung für technische Produkte und Plattformen, deren Zielgruppe Coding-Assistenten aktiv nutzt.
Der häufigste Fehler, den wir 2026 beobachten: Unternehmen fragen sich, ob sie llms.txt brauchen, während ihre KI-Search-Crawler im Server-Log 403-Fehler produzieren. Die Antwort auf die falsche Frage hat noch nie ein Problem gelöst.
Schema.org und llms.txt – häufige Fragen
Was ist der Unterschied zwischen schema.org und llms.txt?
Schema.org ist ein offizieller Web-Standard, der auf Seitenebene Bedeutung und Kontext für Maschinen definiert. llms.txt ist eine Community-Convention auf Domainebene, die KI-Agenten eine kuratorische Prioritätsliste der wichtigsten Seiten gibt. Beide Konzepte arbeiten auf unterschiedlichen Ebenen und schließen sich nicht aus.
Hilft llms.txt beim Google-Ranking?
Nein. Google hat explizit erklärt, llms.txt nicht zu verwenden und das auch nicht zu planen. Die Datei ist kein Ranking-Signal für Google Search oder AI Overviews.
Muss ich meine KI-Crawler in robots.txt erlauben?
Kommt darauf an, welche Bots du meinst. Trainingscrawler wie GPTBot oder ClaudeBot kannst du bedenkenlos blockieren, wenn du nicht möchtest, dass deine Inhalte für Modelltraining genutzt werden. Search-Crawler wie OAI-SearchBot oder PerplexityBot solltest du erlauben, wenn du in KI-Suchantworten sichtbar sein willst.
Ist FAQPage-Schema nach der Abschaffung der FAQ-Rich-Results noch sinnvoll?
Ja. Google hat die visuellen FAQ-Snippets im Mai 2026 eingestellt, das Markup selbst ist aber weiterhin valide und wird von KI-Crawlern ausgewertet. Frage-Antwort-Strukturen in maschinenlesbarem Format erleichtern Sprachmodellen die Extraktion zitierfähiger Antworten erheblich.
Wie prüfe ich, ob KI-Bots meine Website crawlen können?
Der zuverlässigste Weg ist die Server-Log-Analyse. Filter die Logs auf die User-Agents der relevanten Bots (OAI-SearchBot, Claude-SearchBot, PerplexityBot) und prüfe, ob sie mit 200-Statuscodes antworten oder ob Fehler wie 403 oder 429 auftauchen. Viele CDN-Konfigurationen blockieren diese Bots, ohne dass der Website-Betreiber es bemerkt.
Die DATA HORIZON unterstützt Unternehmen dabei, ihre Website technisch und inhaltlich fit für KI-Crawler zu machen – von der schema.org-Implementierung über die robots.txt-Konfiguration bis hin zur vollständigen GEO-Strategie. Möchten Sie wissen, ob Ihre Website von OAI-SearchBot, Claude-SearchBot und Perplexity überhaupt gecrawlt wird – oder ob das Schema-Markup korrekt implementiert ist? Nehmen Sie jetzt Kontakt auf und lassen uns gemeinsam schauen, was auf Ihrer Website noch fehlt.